
Pantalla grande
Pantalla pequeña
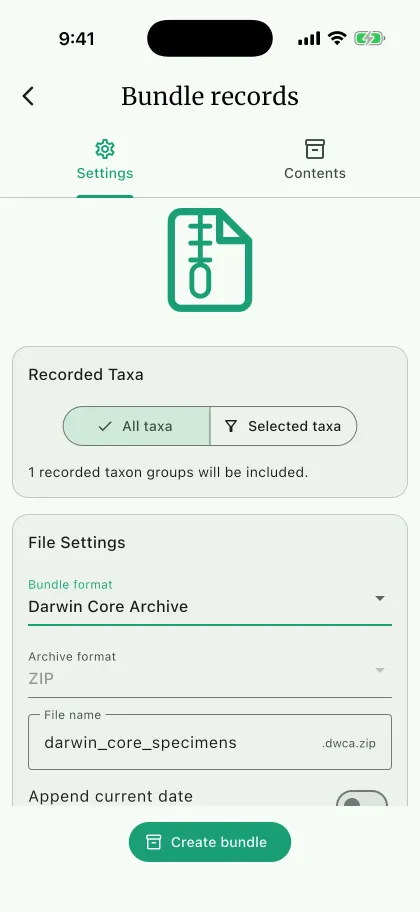
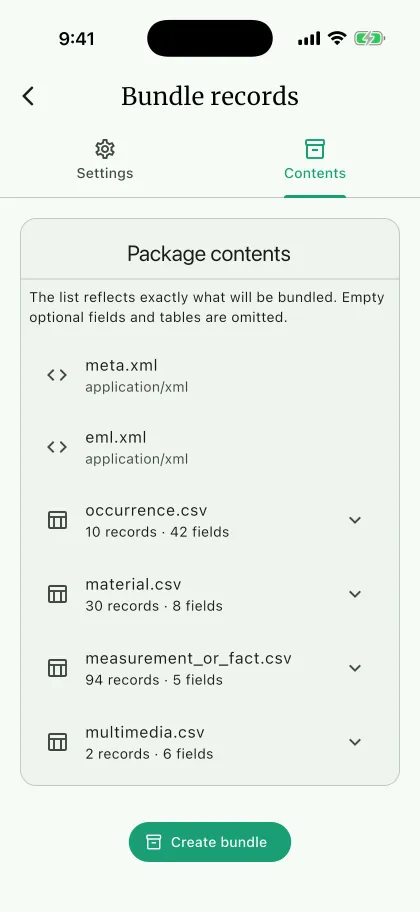
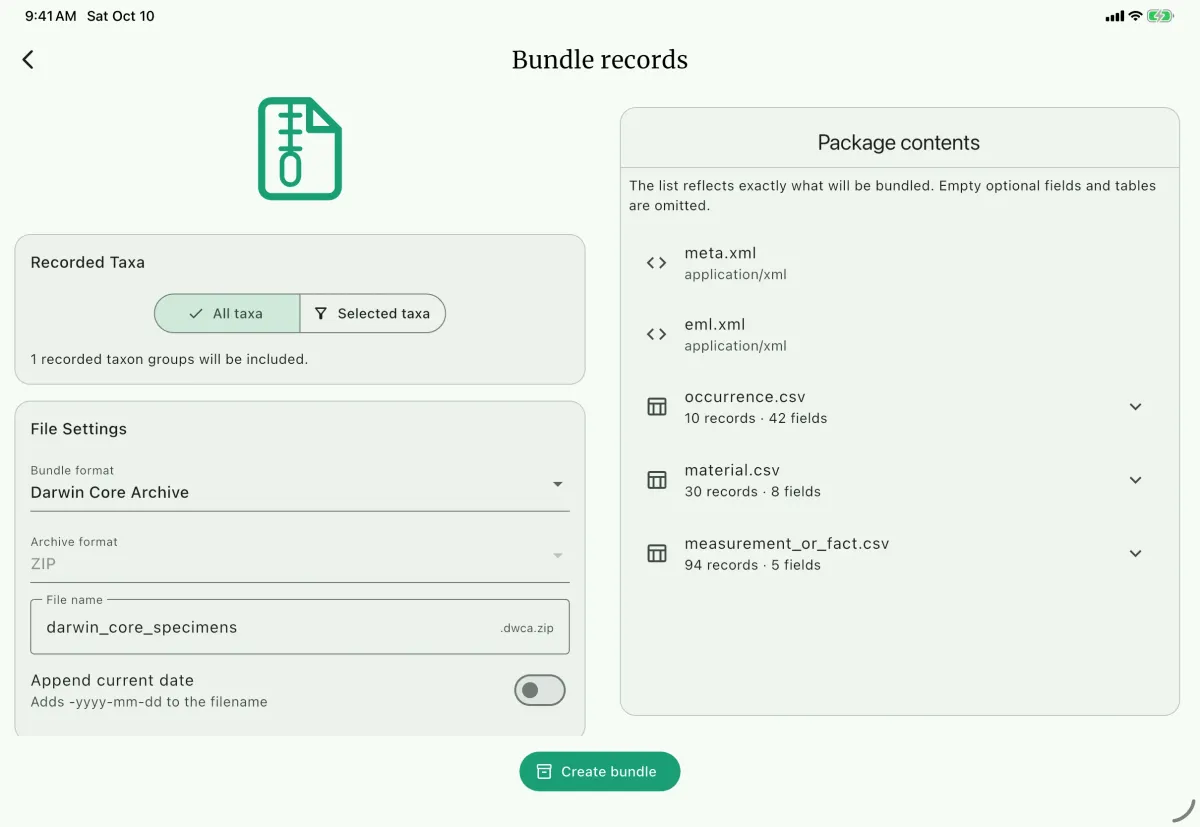
Use Empaquetar registros para reunir los datos del proyecto junto con sus metadatos y multimedia para publicación, archivo o análisis reproducible. Antes de escribir nada, Contenido del paquete muestra cada archivo, conteo de registros, columnas y advertencias.
Elegir un formato de paquete
Sección titulada «Elegir un formato de paquete »| Formato | Elíjalo cuando | Contiene | NAHPU puede importarlo |
|---|---|---|---|
Darwin Core Archive (.dwca.zip) | Un museo o portal de biodiversidad (como GBIF) solicita DwC-A | Especímenes en una tabla central plana, con partes, medidas y multimedia en tablas de extensión | No |
Darwin Core Data Package (.dwc-dp.tar.gz) | El destinatario admite el estándar relacional más reciente de Darwin Core | Especímenes, eventos, identificaciones, partes y personas en tablas Darwin Core vinculadas | No |
NAHPU Data Package (.nahpu-dp.tar.gz) | Necesita todos los datos para análisis en R o Python, archivo a largo plazo o copia completa | El proyecto completo, todas las tablas pobladas de NAHPU, configuraciones de usuario y archivos | Sí, con Importar proyecto o Combinar proyecto |
Los paquetes Darwin Core solo incluyen valores con un término exacto registrado en Darwin Core, Dublin Core o Audubon Core. Elija NAHPU Data Package cuando no pueda perderse ningún dato, incluidos los campos personalizados. Puede leerse con cualquier herramienta Frictionless; consulte el Tutorial 3.
Crear un paquete
Sección titulada «Crear un paquete»- Abra el menú del proyecto y seleccione
Empaquetar registros. - Elija el formato del paquete B.
- Elija el formato de archivo comprimido C cuando el paquete admita más de un contenedor:
TAR.GZes el predeterminado para paquetes de datos.ZIPestá disponible para herramientas y sistemas que prefieren archivos ZIP estándar.- Darwin Core Archive siempre usa
ZIP.
- En un paquete Darwin Core, elija
Todos los taxonesA oTaxones seleccionados. Seleccionar mamíferos también incluye murciélagos. - Escriba el nombre del archivo D (opcionalmente active
Añadir fecha) y seleccione la carpeta de destino en escritorio. - Revise
Contenido del paqueteE (en teléfonos, bajo la pestaña de contenido). Expanda cualquier recurso CSV F para inspeccionar sus columnas. - Revise las advertencias, como multimedia faltante o el aviso de compatibilidad ZIP para DwC-DP.
- Seleccione
Crear paqueteG. Puede cancelar mientras se genera. Al terminar, compártalo, abra la carpeta, guarde una copia o elijaEmpaquetar otro.
Elegir un contenedor de archivo
Sección titulada «Elegir un contenedor de archivo»| Contenedor | Extensiones típicas | Notas |
|---|---|---|
TAR.GZ | .dwc-dp.tar.gz, .nahpu-dp.tar.gz | Predeterminado para Data Packages y la opción recomendada por el estándar DwC-DP. Al extraer, datapackage.json y los metadatos quedan en la raíz. |
ZIP | .dwca.zip, .dwc-dp.zip, .nahpu-dp.zip | Obligatorio para Darwin Core Archive; opción normal para NAHPU Data Package; opción de compatibilidad para DwC-DP (muestra advertencia porque la guía DwC-DP prefiere gzip). |
Detalles técnicos
Sección titulada «Detalles técnicos»Las secciones siguientes explican qué archivos escribe cada paquete y cómo NAHPU asigna los registros. Úselas si un destinatario consulta la estructura o al procesar el paquete mediante scripts.
Darwin Core Archive
Sección titulada «Darwin Core Archive »Un Darwin Core Archive (DwC-A) es un paquete de intercambio centrado en especímenes basado en las Darwin Core Text Guidelines.
Alcance y cobertura de campos
Sección titulada «Alcance y cobertura de campos»Los grupos taxonómicos seleccionados determinan las ocurrencias incluidas. NAHPU sigue sus vínculos para añadir eventos de recolección, partes de especímenes y entidades materiales, mediciones, multimedia y personas (colectores, catalogadores, preparadores y creadores de multimedia). Los campos opcionales vacíos y las tablas de extensión vacías se omiten.
Solo se escriben columnas con un término exacto registrado de Darwin Core, Dublin Core o Audubon Core; los demás campos se omiten y se muestran como retenidos en Contenido del paquete. Use un NAHPU Data Package si necesita conservar absolutamente todos los valores.
Archivos raíz y relaciones
Sección titulada «Archivos raíz y relaciones»- meta.xml
- eml.xml
- occurrence.csv
- material.csv
- measurement_or_fact.csv
- multimedia.csv
Directoriomedia/
- …
Solo se crean los archivos con datos:
meta.xmldescribe el núcleo de ocurrencias, las extensiones, las posiciones de columna y las URI de términos Darwin Core.eml.xmlcontiene metadatos a nivel de conjunto de datos.occurrence.csves siempre la tabla central.- Las extensiones apuntan al núcleo: las partes se exportan en
material.csv, las medidas enmeasurement_or_fact.csvymultimedia.csvvincula cada ocurrencia con su ruta bajomedia/.
Salida: <nombre-archivo>.dwca.zip.
Darwin Core Data Package
Sección titulada «Darwin Core Data Package»Un Darwin Core Data Package (DwC-DP) representa datos Darwin Core como tablas relacionales normalizadas según la especificación Darwin Core Data Package y el modelo Frictionless Data Package.
Archivos raíz
Sección titulada «Archivos raíz»- datapackage.json
- eml.xml
- occurrence.csv
- identification.csv
- event.csv
- material.csv
- occurrence-assertion.csv
- media.csv
- agent.csv
- occurrence-agent-role.csv
- event-agent-role.csv
- material-agent-role.csv
- media-agent-role.csv
- occurrence-media.csv
Directoriomedia/
- …
Las tablas opcionales solo se escriben si hay datos. datapackage.json declara el perfil DwC-DP, cada recurso CSV, orden de campos, claves primarias, claves foráneas y predicados de relación. Las columnas estructurales _pk y _fk preservan los enlaces relacionales junto con los identificadores legibles.
Mapeo de datos
Sección titulada «Mapeo de datos»NAHPU distribuye cada dato en la clase que corresponde al estándar en lugar de repetirlo en occurrence.csv:
occurrence: ocurrencia del espécimen;identification: determinación y rangos taxonómicos;event: actividad de recolección y localidad;material: partes del espécimen, catálogo y preparación;occurrence-assertion: mediciones y aserciones sin columna propia (como asociación con hospedero);agenty*-agent-role: personas y roles (priorizando URL canónicas de ORCID, con UUID de NAHPU como respaldo);mediayoccurrence-media: metadatos y vínculos multimedia.
Se aplica la misma regla estricta de términos registrados que en DwC-A. Las coordenadas DDM, DMS o UTM originales se conservan como texto literal, la extensión positiva de captura se suma a la incertidumbre de coordenadas y se mantienen las unidades de peso elegidas.
En invertebrados, sexo, etapa de vida, casta, asociación con hospedero y observaciones son términos de ocurrencia; la parte del hospedero y las medidas morfométricas opcionales (ancho cefálico, longitud corporal y envergaduras alar superior e inferior) salen como aserciones MeasurementOrFact en milímetros. La cobertura del dosel y los parámetros ambientales se asocian al evento de recolección con unidades definidas (°C, %, mg/L, m/s, mm, okta).
Salida: <nombre-archivo>.dwc-dp.tar.gz (predeterminado) o <nombre-archivo>.dwc-dp.zip (compatibilidad, con advertencia).
NAHPU Data Package
Sección titulada «NAHPU Data Package »NAHPU Data Package es el formato completo y reproducible de NAHPU: un Frictionless Data Package con metadatos propios. A diferencia de los paquetes Darwin Core, no filtra por grupo taxonómico: empaqueta el JSON completo de transferencia del proyecto activo, tablas CSV tipadas equivalentes, mapeos de enumeraciones, instantáneas de vocabularios controlados, configuraciones de usuario y archivos asociados.
Es el único paquete que conserva campos personalizados sin término Darwin Core. Solo se exportan las tablas con datos en el proyecto (un proyecto solo de mamíferos no incluye tablas de aves, herpetofauna, invertebrados ni peces) y mappings/sqlite_enums.csv incluye únicamente las columnas enumeradas de esas tablas pobladas.
Estructura raíz
Sección titulada «Estructura raíz»- datapackage.json
- nahpu.toml
- nahpu-project.json
Directoriotables/
- project.csv
- ...
Directorioconfigs/
- user_configs.json
Directoriomappings/
- sqlite_enums.csv
Directoriovocabularies/
- site.csv
- events.csv
- specimens.csv
- symbionts.csv
Directoriofiles/
- ...
Directoriomedia/
- ...
Las tablas vacías se omiten de tables/ y datapackage.json, mientras que los recursos de metadatos (mappings/sqlite_enums.csv y vocabularies/*.csv) siempre se incluyen (solo con su fila de encabezados si no tienen registros).
JSON del proyecto y tablas CSV
Sección titulada «JSON del proyecto y tablas CSV»nahpu-project.json es la misma carga versionada que genera Exportar proyecto (proyecto activo, registros relacionados, manifiesto multimedia, metadatos y advertencias), conservando distinciones como null frente a cadena vacía sin requerir SQLite. Los CSV bajo tables/ provienen de la misma carga para mantener coherencia; las colecciones vacías se conservan en nahpu-project.json para transferencia aunque se omitan como CSV.
Mapeos de enumeraciones SQLite
Sección titulada «Mapeos de enumeraciones SQLite»mappings/sqlite_enums.csv traduce los índices enteros almacenados en las tablas exportadas. Cada fila registra tabla SQLite, columna, tipo de enumeración, índice entero desde cero, nombre estable en código y etiqueta legible de NAHPU.
Los mapeos incluidos (limitados a las tablas pobladas del paquete) cubren:
- sexo del espécimen (
mammalAttribute,birdAttribute,herpAttribute,invertebrateAttribute,fishAttributeyspecimenIndividual), con códigos estables donde0,1y2mantienen su significado histórico; - confianza de identificación (
specimen.iDConfidence); - tipo de espécimen en peces (
Individual/Lot) y casta en invertebrados; - campos reproductivos de mamíferos y categorías de ecolocalización;
- campos reproductivos y de muda de aves.
Los enteros booleanos y las mediciones numéricas no son índices de enumeración y no aparecen en este archivo.
Vocabularios controlados
Sección titulada «Vocabularios controlados»Cuatro recursos CSV registran los vocabularios controlados activos en la configuración de NAHPU (o los valores predeterminados si no se modificaron):
vocabularies/site.csv: tipos de sitio y tipos de hábitat;vocabularies/events.csv: métodos de recolección y roles del personal;vocabularies/specimens.csv: tipos de espécimen, tratamientos, condiciones, opciones habilitadas de sexo, métodos de identificación y etapas de vida;vocabularies/symbionts.csv: tipos de interacción, categorías, métodos de detección, métodos de preparación, ubicaciones anatómicas, almacenamiento y tratamientos de simbiontes.
Cada fila incluye clave de configuración, nombre del vocabulario, posición desde cero y valor, permitiendo leerlos directamente sin analizar configs/user_configs.json.
Descriptor Frictionless y análisis
Sección titulada «Descriptor Frictionless y análisis»datapackage.json usa el perfil estándar data-package, declarando cada tabla poblada como recurso tabular UTF-8 con orden de columnas, tipos, restricciones, claves primarias y foráneas, junto con los esquemas de enumeraciones, vocabularios y recursos no tabulares.
Extraiga el archivo comprimido antes de abrir datapackage.json, pues sus rutas son relativas a la raíz del paquete. Compruebe si existe una tabla opcional antes de leerla:
from collections import Counter
from frictionless import Package
package = Package("/path/to/extracted-package/datapackage.json")print(package.resource_names)
if package.has_resource("specimen"): specimens = package.get_resource("specimen").read_rows() counts = Counter(row["taxonGroup"] or "Unspecified" for row in specimens) print(counts)library(frictionless)
package <- read_package("/path/to/extracted-package/datapackage.json")resource_names(package)
if ("specimen" %in% resource_names(package)) { specimens <- read_resource(package, "specimen") print(table(specimens$taxonGroup, useNA = "ifany"))}Manifiesto de reproducibilidad, configuraciones y archivos
Sección titulada «Manifiesto de reproducibilidad, configuraciones y archivos»nahpu.tomlregistra nombre y versión del formato, fecha y hora de exportación, versión y compilación de la aplicación, versiones de esquema de base de datos y configuraciones, conteos de tablas/enumeraciones/vocabularios y versiones de los crates denahpu_api(nahpu_dp,nahpu_dwc,nahpu_db,nahpu_configs, entre otros).configs/user_configs.jsonalmacena la exportación versionada de configuraciones de usuario (configuración general, ajustes de exportación de registros, plantillas y diseños de documentos).media/yfiles/incluyen la multimedia referenciada del proyecto, las fotos del personal referenciado (bajomedia/con rutas compatibles con transferencia) y las fuentes personalizadas instaladas (bajofiles/). Los archivos faltantes generan advertencias.
Salida: <nombre-archivo>.nahpu-dp.tar.gz (predeterminado) o <nombre-archivo>.nahpu-dp.zip, con idéntico contenido interno.
Paquete frente a respaldo
Sección titulada «Paquete frente a respaldo»| Paquete Darwin Core | NAHPU Data Package | Respaldo de base de datos | |
|---|---|---|---|
| Restaura un proyecto en NAHPU | No | Sí (Importar proyecto o Combinar proyecto) | Sí (toda la instalación) |
| Propósito principal | Intercambio con sistemas externos | Copia documentada y reutilizable de un proyecto | Recuperación completa del dispositivo |
Un NAHPU Data Package abarca solo un proyecto, por lo que debe seguir creando respaldos de la base de datos periódicos.
Quienes deseen ampliar campos de paquetes o grupos taxonómicos pueden consultar Flujos de exportación y Agregar un grupo taxonómico.
Validación del paquete y advertencias
Sección titulada «Validación del paquete y advertencias»Antes de escribir, NAHPU valida campos obligatorios y relaciones; al finalizar, reabre el archivo para confirmar que existan los metadatos raíz. Las advertencias —como multimedia faltante o modo de compatibilidad ZIP en DwC-DP— no siempre impiden la exportación, así que revíselas antes de compartir o depositar el paquete.